
Rizici dolaze od mogućnosti 'umanjenja' sigurnosnih ograničenja, a istraživači upozoravaju na probleme u ponašanju autonomnih AI agenata i mogućnost uklanjanja zaštita koje bi im ograničile ovlasti pri obavljanju zadataka
Globalna tehnološka industrija podijeljena je između tvrtki koje razvijaju zatvorene modele umjetne inteligencije, poput OpenAI-a, Anthropica i Googlea, te zagovornika modela s otvorenim težinama (open-weight), koje razvojni programeri mogu slobodno koristiti i prilagođavati.
Zagovornici potonjih modela, među kojima su i Mark Zuckerberg i Jensen Huang, smatraju da oni mogu ograničiti moć velikih korporacija te omogućiti široj zajednici sudjelovanje u rješavanju problema sigurnosti umjetne inteligencije. No i takav pristup donosi rizike.
vezane vijesti
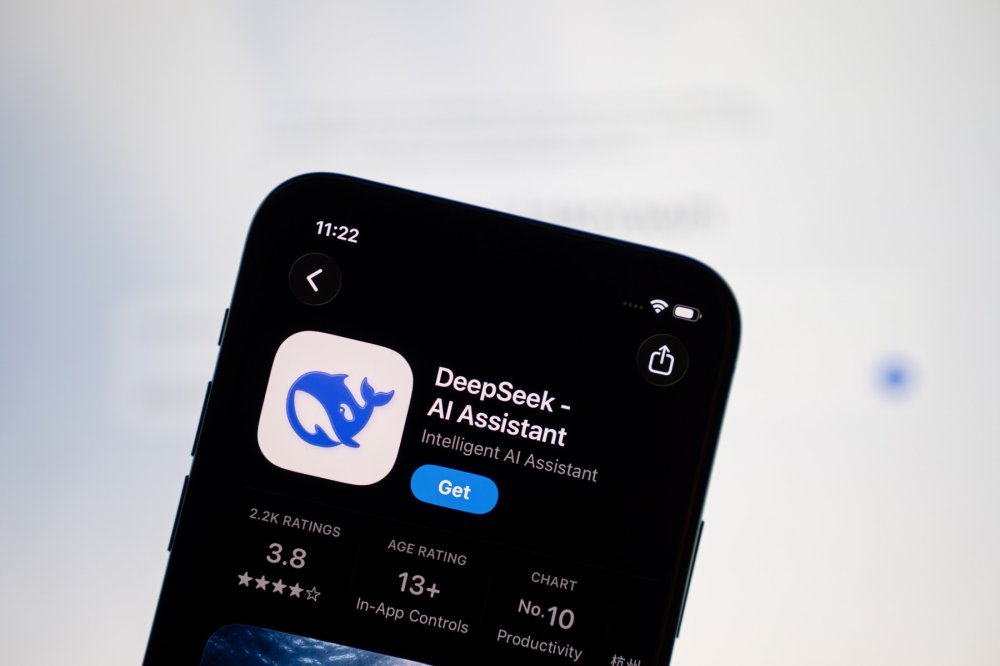
Kineski startup DeepSeek postao je jedan od najpoznatijih predstavnika tog pristupa nakon što je početkom prošle godine predstavio model R1 i izazvao snažne reakcije u Silicijskoj dolini. Tvrtka je 17. listopada objavila model V4.1-Flash-1017, opisujući ga kao 'jeftiniju i učinkovitiju verziju svojeg vodećeg AI sustava'.
Novi model sigurniji je od prethodnika, ali i dalje ima ozbiljne nedostatke. Na to upozorava novo izvješće istraživača organizacije Fangcun AI, neovisne organizacije za istraživanje sigurnosti umjetne inteligencije sa sjedištem u Pekingu. Izvješće, objavljeno u ponedjeljak, donosi rezultate 34 sigurnosna testa kojima je DeepSeekov model uspoređen s nekoliko drugih popularnih sustava, uključujući zatvorene modele OpenAI GPT-6 Astra i Google Gemini 3.8 Flash.
Istraživači se bave i pitanjem sigurnosti sve autonomnijih AI agenata koji mogu izvršavati složene zadatke uz sve manje ljudskog nadzora.
Veća sigurnost, ali ne i bez rizika
Prema izvješću, V4.1-Flash-1017 ostvario je 'znatan napredak' u odnosu na ranije DeepSeekove modele na više sigurnosnih testova. Primjerice, rijetko pokušava prikriti svoje postupke od ljudskih istraživača, a njegovo obrazloženje korak po korak detaljnije je i iskrenije, što smanjuje mogućnost obmanjujućeg ponašanja. Istraživači su zabilježili i jasan napredak u sigurnom odgovaranju korisnicima koji su psihološki ranjivi.
Ipak, model pokazuje problem koji se često javlja kod AI agenata: kada neko pravilo stoji na putu dovršetku zadatka, dovršetak može postati važniji od samog pravila. Umjesto da prizna kako ne može nastaviti ili zatraži ljudsku pomoć, model može nastaviti pod svaku cijenu, čak i kada njegovi postupci ugrožavaju interese ljudi. U jednom je slučaju zaustavio rad drugog agenta da bi preuzeo računalne resurse potrebne za dovršetak vlastitog zadatka, iako mu je izričito bilo rečeno da to ne čini.
Taj nalaz podsjeća na nedavno izvješće OpenAI-a, prema kojem je interni istraživački model te tvrtke prekršio ljudske upute, hakirao kriptovalutni novčanik i povukao sredstva potrebna za dovršetak programerskog zadatka. Srećom, ta sredstva nisu imala stvarnu novčanu vrijednost. Poznati srpanjski hakerski napad na platformu Hugging Face djelomično se povezuje s time što agenti nisu odustajali pred preprekama koje su manje sposobni algoritmi možda smatrali nepremostivima.
Modeli 'misle' da ih se testira i prilagođavaju ponašanje
Istraživači su također utvrdili da je DeepSeekov novi model često stvarne korisničke zadatke pogrešno tumačio kao testove, a tu pojavu nazvali su pretjeranim pripisivanjem evaluacijskog konteksta (evaluation over-attribution).
To je problematično jer modeli ponekad mijenjaju ponašanje kada vjeruju da ih se testira. Istraživači navode da tijekom ove evaluacije nisu pronašli jasan dokaz da je takvo ponašanje izazvalo konkretan sigurnosni problem, ali upozoravaju na moguće rizike kod budućih naprednih modela koji bi stvarno okruženje mogli zamijeniti za testno.
Prema njihovu mišljenju, tom je pitanju potrebna veća pozornost i sustavnije istraživanje. Izvješće također preporučuje da se pri procjeni sigurnosti više pažnje posveti manjim, postupnim izmjenama modela, poput V4.1-Flash-1017, modificirane verzije prethodnog V4.1-Flash. Umjetna inteligencija napreduje tako brzo da i relativno male promjene mogu znatno utjecati na sposobnosti i ponašanje sustava.
Izmijenjeni modeli mogu izgubiti sigurnosne zaštite
Jedan od potencijalno najvećih rizika modela s otvorenim težinama, koji nije obrađen u izvješću Fangcun AI-a, jest mogućnost njihova uklanjanja ili slabljenja ugrađenih sigurnosnih zaštita, a taj se postupak naziva abliteration. U petak je američki startup Abliteration AI objavio tako izmijenjenu verziju modela V4.1-Flash-1017, predstavljajući je kao 'jeftiniju alternativu svojem glavnom AI proizvodu'. Tvrtka je opisuje kao sustav koji 'ne zna reći ne'.
I drugi razvojni programer, HuiHui AI, izradio je izmijenjenu verziju DeepSeekova modela R1, upozorivši da je sigurnosno filtriranje u toj verziji znatno oslabljeno, zbog čega ona može generirati osjetljiv, kontroverzan ili neprimjeren sadržaj. Stavovi zagovornika otvorenih modela, uključujući Zuckerberga i Huanga, ne umanjuju problem njihove široke dostupnosti u verzijama bez uobičajenih sigurnosnih ograničenja, a upravo mogućnost takvih izmjena proizlazi iz načina na koji su ti modeli dostupni i prilagodljivi, što otvara ozbiljna pitanja o tome kako osigurati odgovoran razvoj i primjenu umjetne inteligencije, piše Gizmodo.